Почему LLM неправильно сопоставляет товары и почему хороший промпт не решит эту проблему
Представьте, что у вас есть два товарных каталога. В одном 10 000 позиций, в другом — 50 000. Нужно найти соответствия между товарами, хотя поставщики используют разные названия, сокращения и форматы.
Кажется, что задача идеально подходит для LLM. Современные языковые модели понимают контекст, распознают синонимы и умеют работать с неструктурированными данными. Достаточно передать им два списка и попросить найти одинаковые товары.
Но на практике всё оказывается сложнее.
Модель может правильно понять оба названия и всё равно предложить неправильное соответствие.
Дело в том, что сходство названий, идентичность товаров и их коммерческая взаимозаменяемость — три разные вещи.
При разработке решений для автоматического сопоставления данных мы убедились, что проблема редко сводится только к качеству LLM. Не менее важны поиск кандидатов в больших каталогах, извлечение характеристик товаров и правила, по которым определяется правильное соответствие.
Разберём, почему возникают ошибки и как организовать процесс сопоставления, чтобы получать более надёжные результаты.
Похожие названия не означают одинаковые товары
Возьмём простой пример.
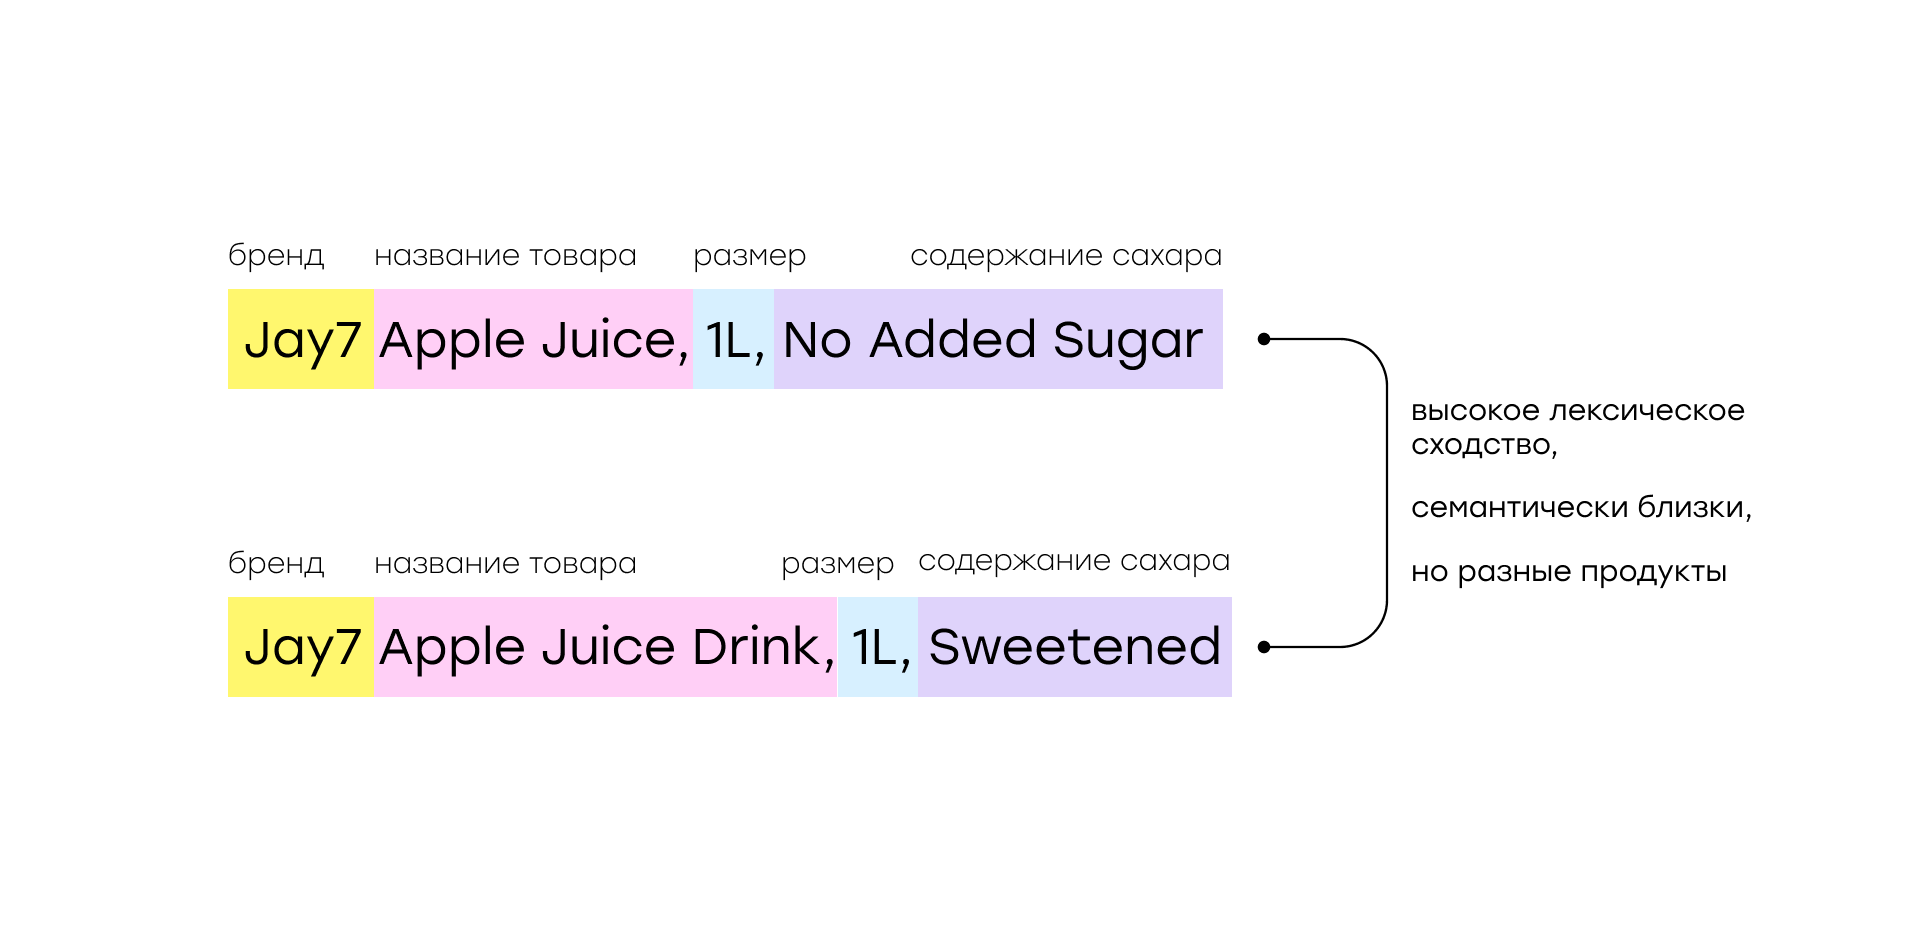
В одном каталоге указано:
Apple Juice, 1L, No Added Sugar
Во втором:
Apple Juice Drink, 1L, Sweetened
Лексическое сходство высокое. Большинство слов совпадает, объём одинаковый, а оба продукта относятся к яблочным напиткам.
Семантически позиции тоже близки.
Но это не идентичные товары. В первом случае речь идёт о соке без добавленного сахара, во втором — о подслащённом сокосодержащем напитке.
Если задача заключается в поиске точного соответствия, такую пару необходимо отклонить.
Теперь рассмотрим обратную ситуацию:
Extra Virgin Olive Oil, 750 ml
и
EVOO, 0.75L
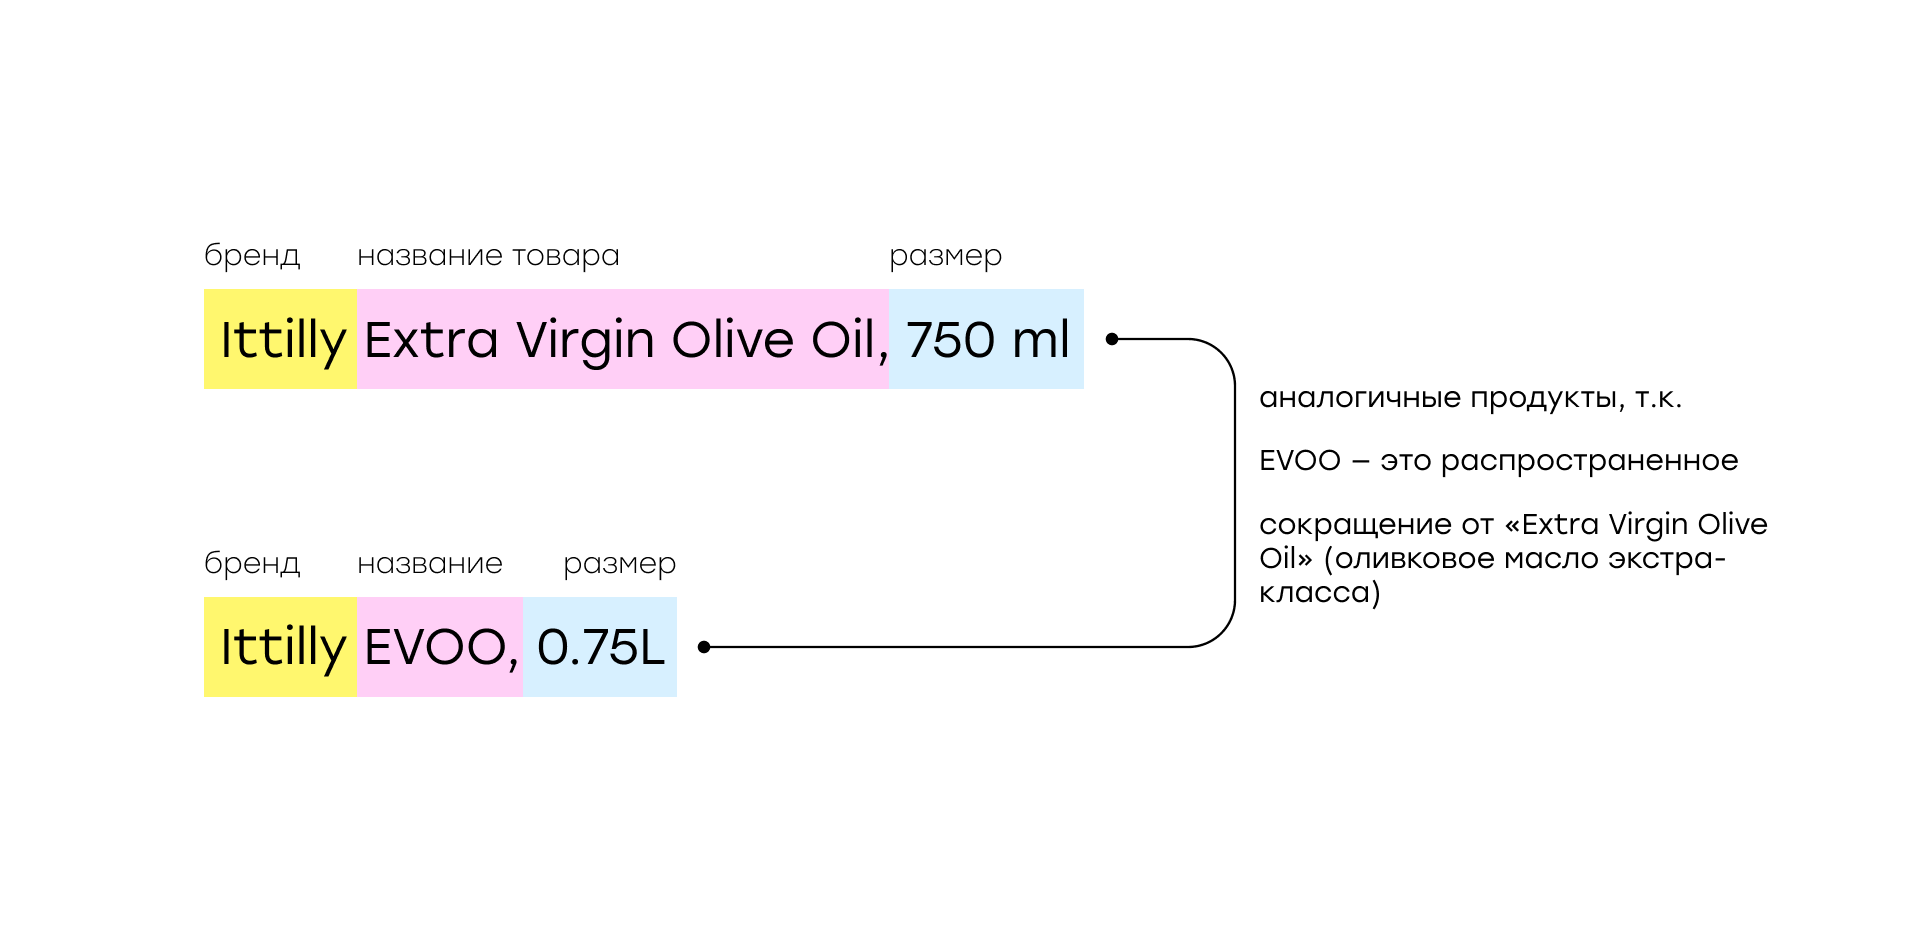
Названия отличаются, но EVOO — распространённое сокращение от Extra Virgin Olive Oil, а объёмы совпадают после нормализации единиц измерения.
При условии совпадения остальных значимых характеристик такая пара может оказаться правильным соответствием.
Эти условные примеры иллюстрируют важную проблему.
Алгоритм может хорошо определять текстовую близость, но этого недостаточно для понимания товарной эквивалентности.
Нужно учитывать свойства продукта и требования конкретной задачи.
Причём иногда бизнесу необходимо найти не идентичный товар, а подходящий аналог. Это означает, что два продукта могут отличаться брендом или некоторыми характеристиками и при этом считаться допустимым соответствием.
Таким образом, вопрос «насколько похожи названия?» необходимо отделять от вопроса «можно ли считать эти товары соответствующими друг другу?».
Иногда правильного ответа просто нет во входных данных
Представим товарную позицию:
Premium Coffee, 250g
По названию можно определить тип продукта и вес. Но этих сведений недостаточно, чтобы уверенно сопоставить его с конкретной позицией другого каталога.
Неизвестны производитель, степень обжарки, сорт кофе и другие потенциально важные характеристики.
Человек, работающий с таким каталогом, может открыть карточку товара на сайте поставщика, найти дополнительную информацию и только после этого принять решение.
LLM, получающая исключительно исходное название, таких данных не имеет.
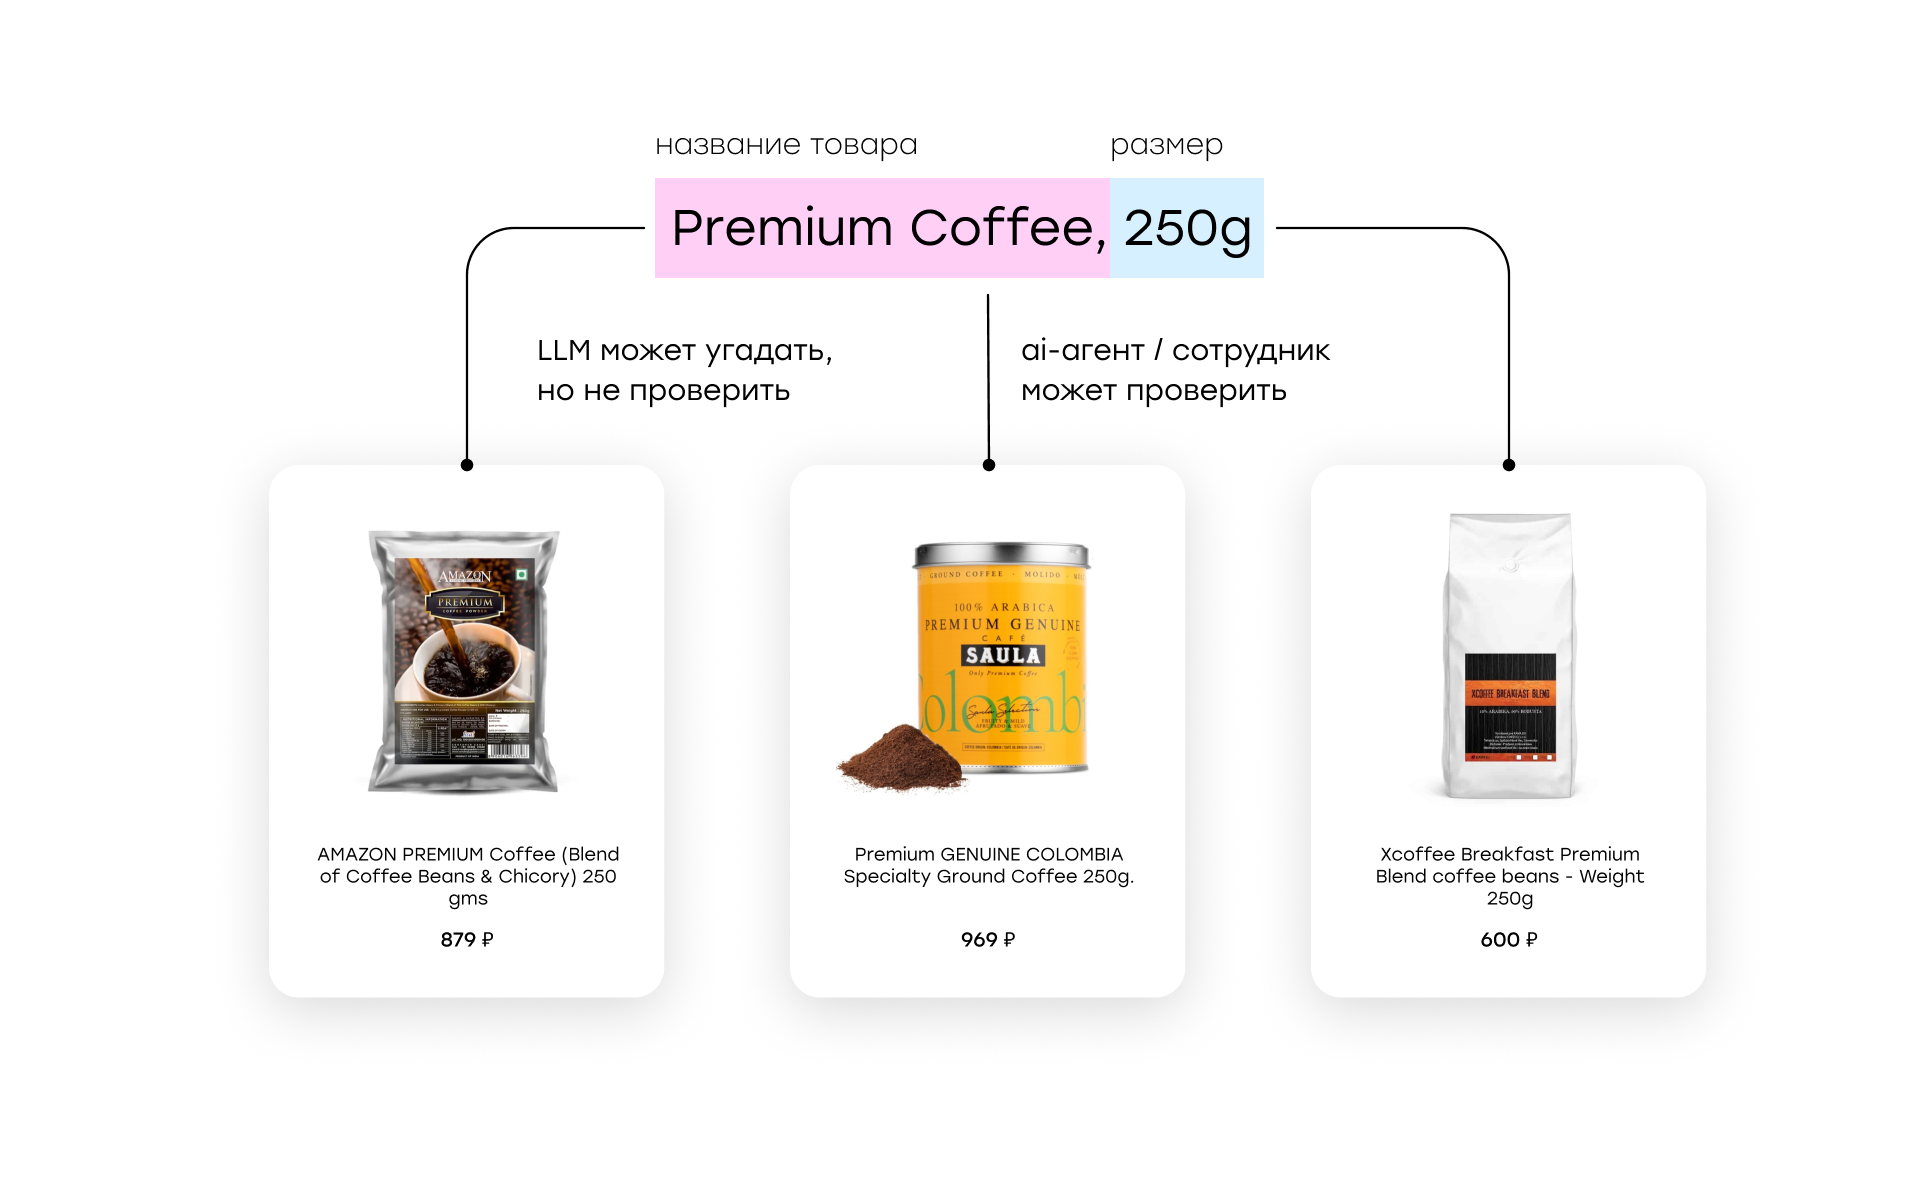
Специалист может предположить недостающие характеристики, опираясь на общие знания, но предположение не равнозначно проверенной информации.
Это особенно важно, когда результат сопоставления используется для подготовки закупок, сравнения цен или обновления данных в ERP.
Неправильно подобранный кандидат в таких процессах может привести к вполне реальным последствиям: некорректному заказу, сравнению несопоставимых товаров или ошибке в учётной системе.
Поэтому перед принятием решения полезно проверить, достаточно ли сведений о товаре.
Если значимый атрибут отсутствует, система может запросить дополнительную информацию, обратиться к внешнему источнику или передать случай человеку.
Не каждую ошибку ИИ можно исправить с помощью более мощного ИИ. Иногда системе просто нужны дополнительные данные.
Почему один большой промпт — плохая идея
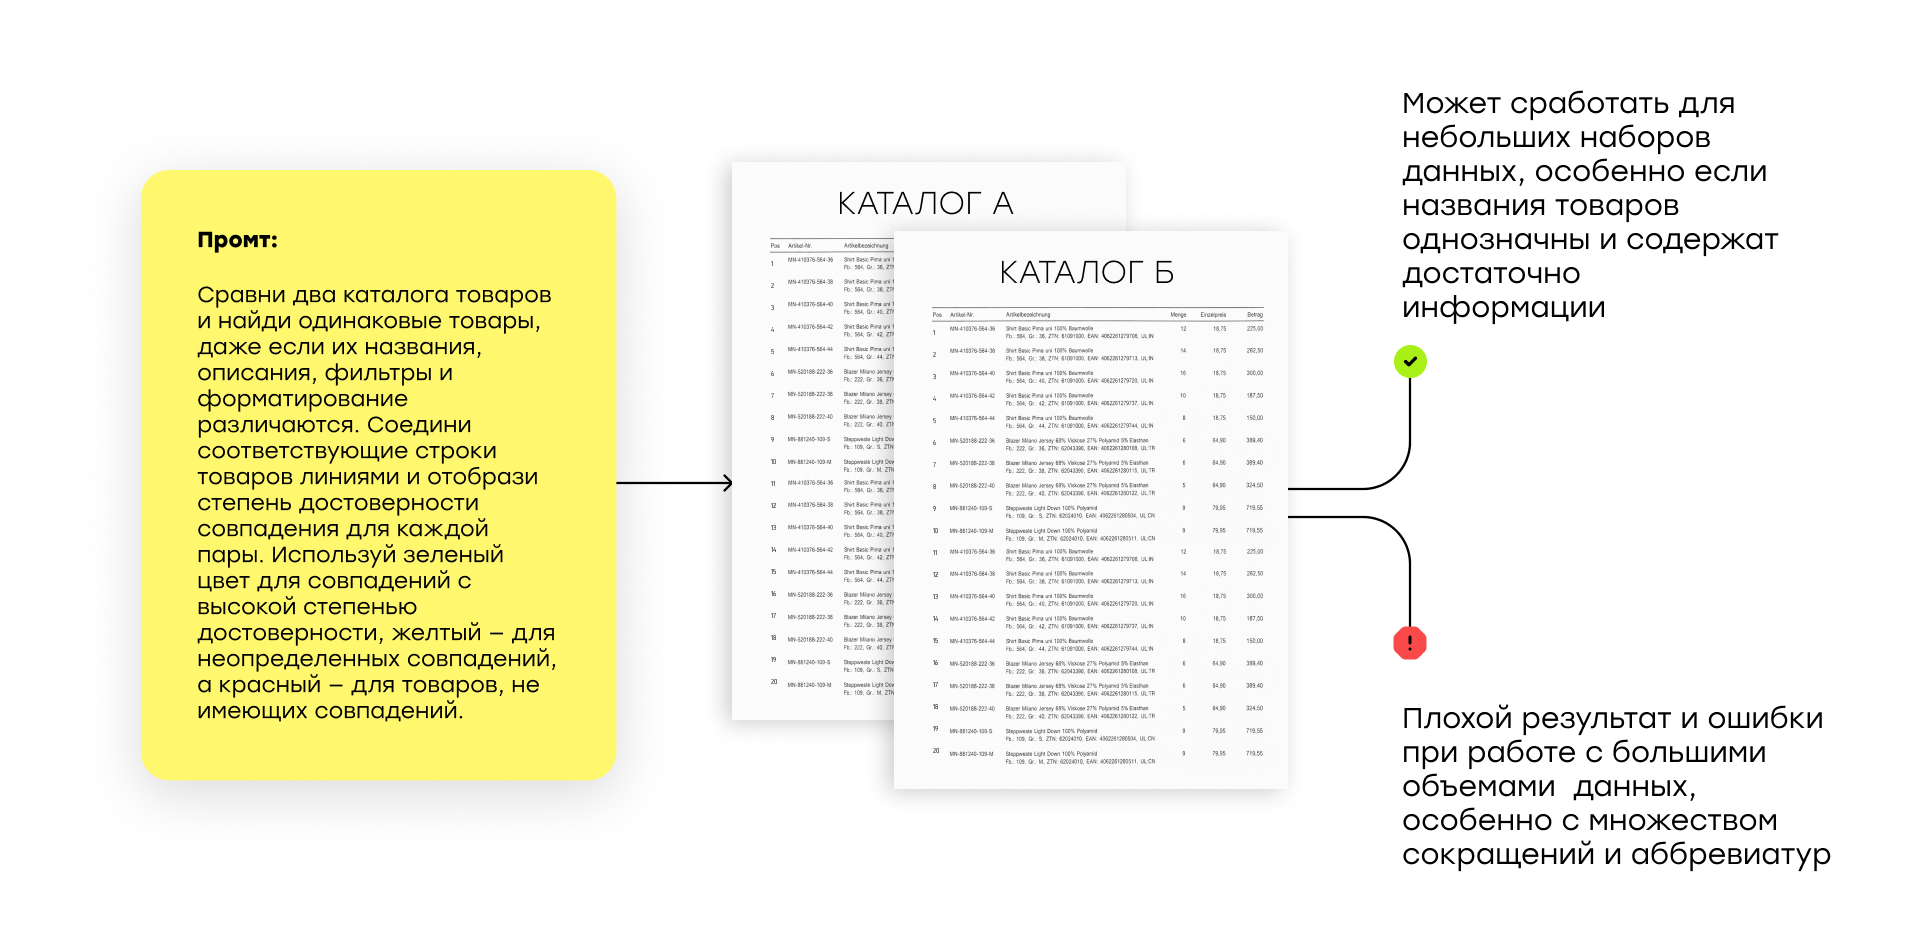
Самый очевидный способ автоматизировать сопоставление — передать LLM два списка товаров и попросить вернуть пары соответствий.
На небольших наборах данных такой подход может работать, особенно когда товары имеют полные и понятные названия.
Но при увеличении объёма каталогов появляются проблемы.
Допустим, необходимо сопоставить 10 000 внутренних позиций с каталогом из 50 000 товаров. Полное попарное сравнение означает 500 миллионов потенциальных комбинаций.
Разумеется, не обязательно отправлять каждую пару в LLM отдельно. Но даже при пакетной обработке анализ такого количества комбинаций потребует значительных ресурсов.
Кроме того, модель должна одновременно искать кандидатов, интерпретировать характеристики и принимать решение об их соответствии.
И становится значительно сложнее диагностировать ошибки.
Допустим, модель предложила неправильный товар. Что произошло?
Она неверно расшифровала сокращение? Пропустила важную характеристику? Вообще не рассмотрела подходящего кандидата? Или неправильно интерпретировала бизнес-правило?
Когда все операции выполняются внутри одного запроса, установить причину ошибки непросто.
Поэтому при работе с большими каталогами мы считаем более практичным разделять задачу на специализированные этапы.
Обычные алгоритмы могут выполнять текстовую очистку и нормализацию. Поисковые механизмы — находить потенциальные соответствия среди тысяч или миллионов позиций. LLM — интерпретировать неоднозначные названия и извлекать характеристики.
Финальную оценку можно выполнять с помощью структурированных признаков, бизнес-правил и отдельного алгоритма ранжирования.
Необязательно использовать LLM для каждой операции, особенно если более простой метод справляется с ней надёжно и с меньшими затратами.
Тратите много времени на сопоставление каталогов?
Прайс-листы поставщиков, внутренние справочники и данные ERP часто используют разные названия и характеристики одних и тех же товаров.
Разработаем AI-решения для автоматического сопоставления товарных позиций, поиска аналогов и проверки соответствий с учётом бизнес-правил компании.
Как построить более практичный процесс сопоставления
Рассмотрим общий подход, который можно использовать при проектировании систем для метчинга каталогов.
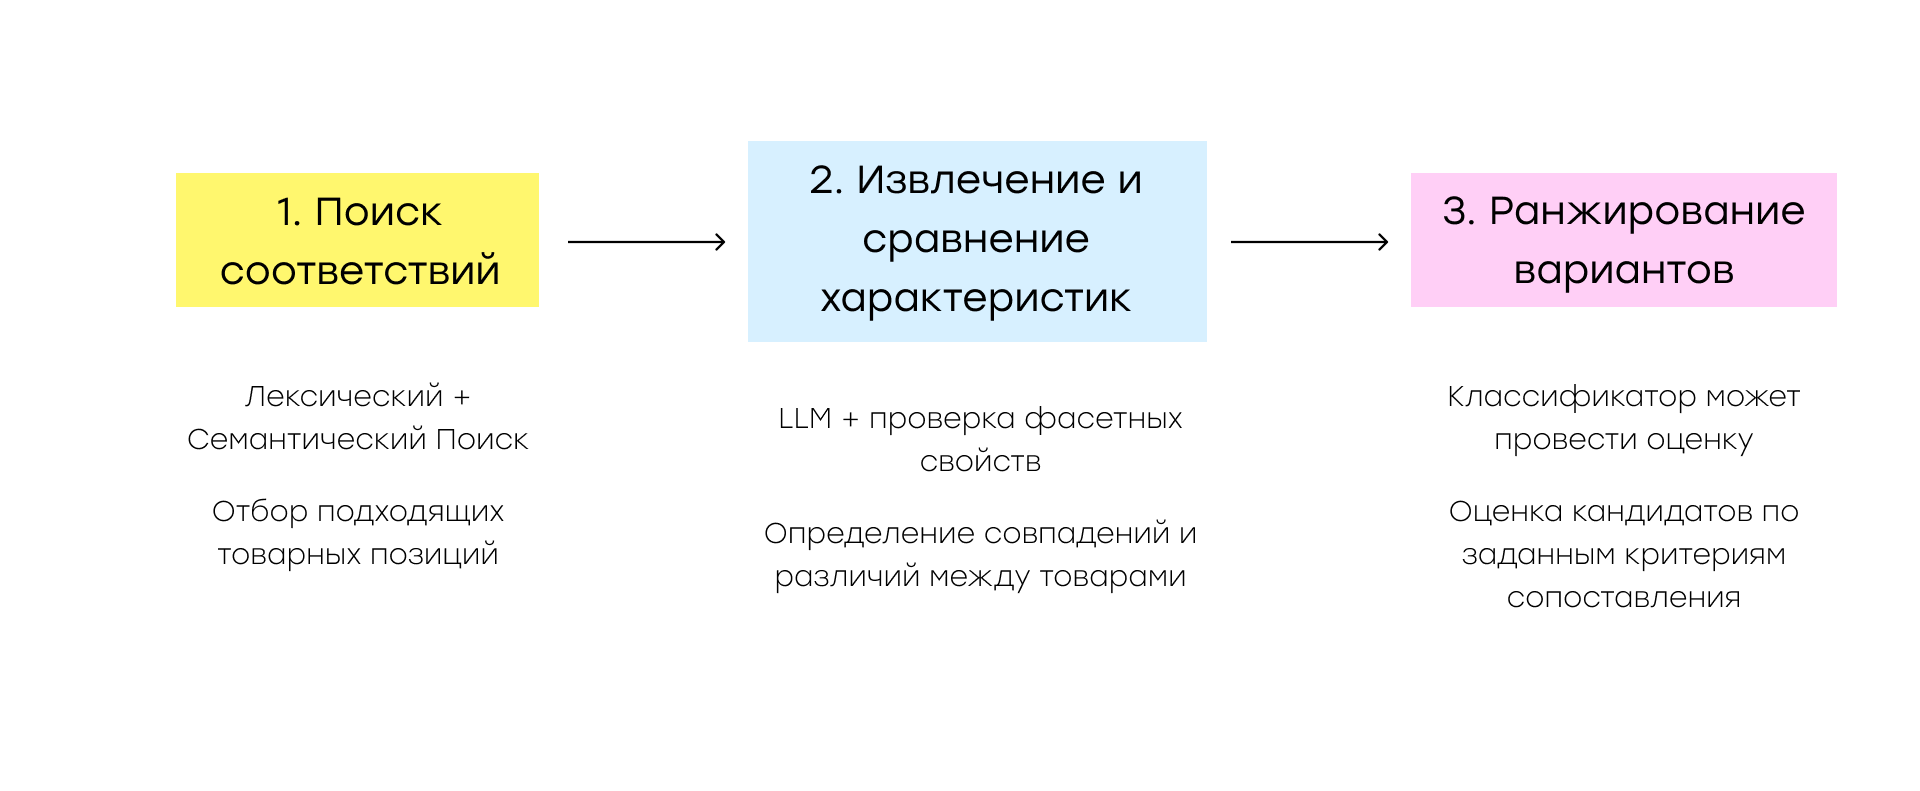
Сначала найдите кандидатов
Вместо сравнения каждого товара со всеми остальными через LLM можно предварительно сузить область поиска.
Для этого часто комбинируют лексическое и семантическое сходство.
Лексический поиск хорошо работает с похожими словами, артикулами и обозначениями.
Семантический поиск помогает находить близкие по смыслу позиции, даже если формулировки отличаются.
Дополнительно можно использовать фасетный поиск — поиск и фильтрацию по структурированным характеристикам товара: категории, бренду, объёму, весу, составу, типу упаковки и другим параметрам.
Например, если в названии товара указано «EVOO 0.75L», после нормализации система может определить категорию «оливковое масло», тип «extra virgin» и объём 750 мл. Эти характеристики помогают сузить поиск до более подходящих позиций, даже если их названия отличаются.
На практике поисковые механизмы могут дополнять друг друга. Лексический поиск находит похожие обозначения, семантический — близкие по смыслу товары, а фасетный позволяет учитывать конкретные характеристики.
Но здесь есть существенное ограничение: если правильный товар не попал в список кандидатов, следующие этапы уже не смогут его выбрать.
Поэтому качество candidate retrieval нужно оценивать отдельно от качества финального ранжирования.
Для одной системы важнее получить короткий список наиболее вероятных соответствий. Для другой — найти максимально полный набор допустимых аналогов.
От этого зависит и стратегия поиска.
Затем сравните фасетные свойства товаров
После отбора кандидатов необходимо понять, какие именно характеристики у них совпадают, а какие различаются.
Такие структурированные характеристики называют фасетами. По сути, это свойства, по которым товар можно описать, искать, фильтровать и сравнивать с другими товарами.
Например, для продуктов питания это могут быть:
- тип продукта;
- состав;
- вес или объём;
- жирность;
- вкус;
- упаковка.
Для электронных компонентов важнее производитель, модель, технические параметры и совместимость.
Одна из сложностей заключается в том, что в товарных каталогах эти свойства не всегда представлены отдельными полями.
Часто информация зашита в свободном тексте наименования, причём в сокращённом или неполном виде.
Здесь LLM особенно полезна: она помогает извлекать фасетные свойства из неструктурированных названий, которые сложно обрабатывать одними регулярными выражениями или словарями.
Но извлечённые характеристики ещё нужно правильно сравнить.
Например:
- «750 ml» и «0.75 L» должны считаться эквивалентными объёмами.
- «Sugar-free» и «sweetened» могут указывать на существенное различие.
- Разные обозначения одной страны не должны автоматически считаться конфликтом.
При этом атрибуты имеют разную значимость.
В одной товарной категории несовпадение производителя недопустимо. В другой продукция разных брендов может рассматриваться как подходящий аналог.
Именно сочетание фасетных свойств и правил их сравнения позволяет перейти от поиска похожих названий к более осмысленному сопоставлению товаров.
Однако фасетный поиск не является универсальным решением. Если характеристика отсутствует или извлечена неправильно, жёсткая фильтрация по ней может исключить подходящий товар. Поэтому важно различать обязательные ограничения и дополнительные сигналы сходства.
Отделите ранжирование от интерпретации языка
После извлечения и сравнения характеристик можно сформировать набор признаков для каждой товарной пары.
Он может включать лексическую и семантическую близость, совпадение производителя, фасетных свойств и другие сигналы.
На основе этих признаков отдельный классификатор или система правил определяет, насколько пара соответствует заданным требованиям.
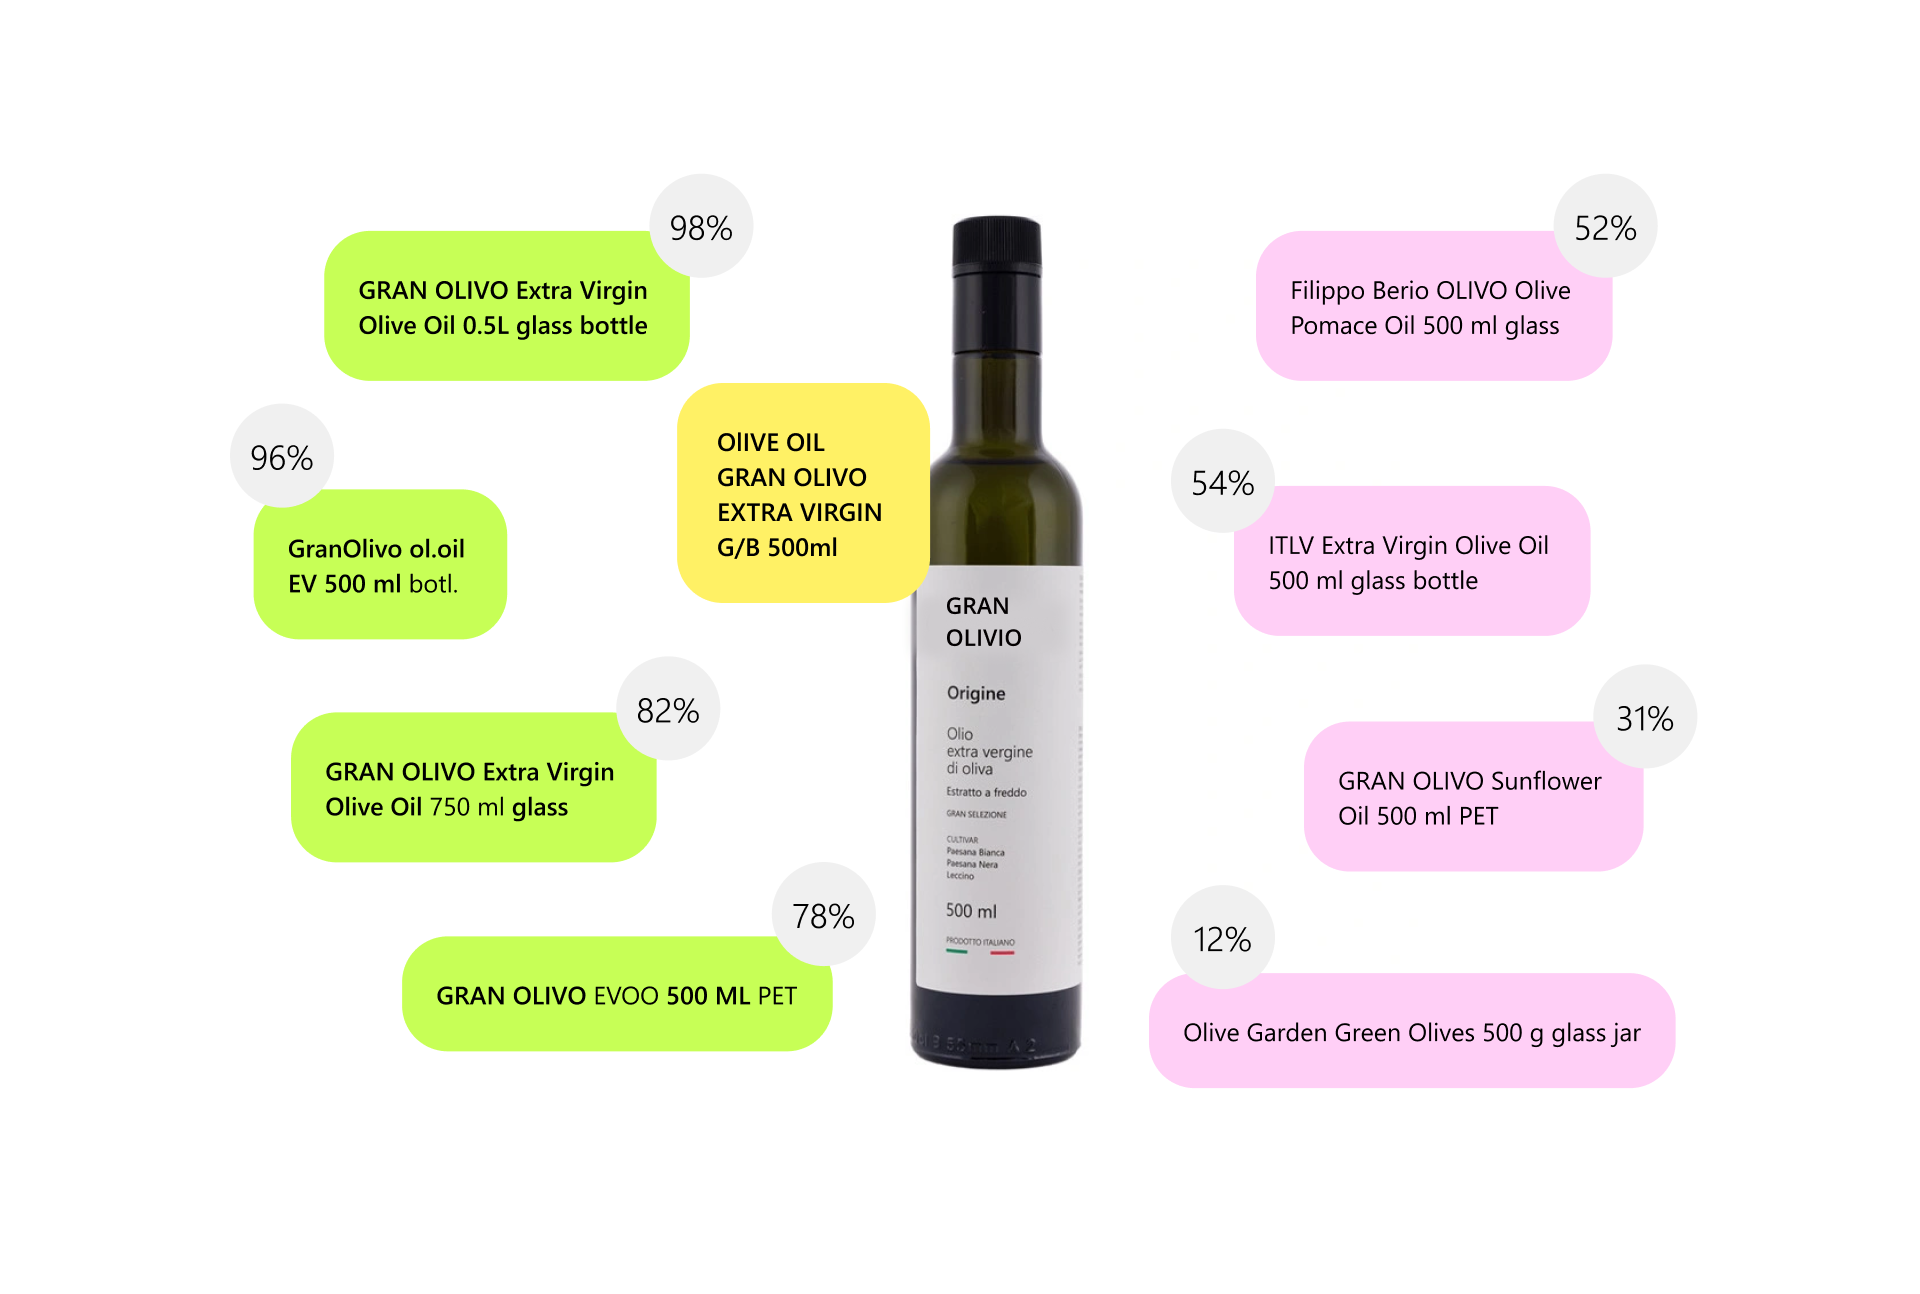
При обработке больших объёмов данных это особенно важно: дорогостоящую языковую модель необязательно использовать для каждого финального сравнения.
Так LLM не приходится самостоятельно выполнять все этапы принятия решения.
Кроме того, появляется возможность отдельно оценивать качество поиска, извлечения характеристик и ранжирования.
Это особенно полезно при отладке.
Если система неправильно сопоставляет товары, можно исследовать конкретный компонент, а не пытаться исправить всё одним изменением промпта.
Не нужно переобучать модель после каждого нового правила
Даже после построения такого процесса остаётся проблема: товарные каталоги постоянно меняются.
Поставщики вводят новые сокращения, появляются новые бренды, меняются характеристики и правила сопоставления.
Один из вариантов адаптации — собирать новые примеры и периодически дообучать модель.
Это оправданный подход, если действительно необходимо изменить её устойчивое поведение.
Но если речь идёт о новом синониме или бизнес-правиле, fine-tuning может оказаться избыточным.
Предположим, компания решила, что для определённой категории допустимо сопоставлять товары разных производителей при условии совпадения обязательных фасетных свойств.
Такое правило удобнее сохранить в конфигурации, чем пытаться закрепить его через новый обучающий цикл LLM.
А как быть с нестандартными соответствиями, которые нельзя описать одним простым правилом?
Здесь может помочь retrieval-augmented generation (RAG).
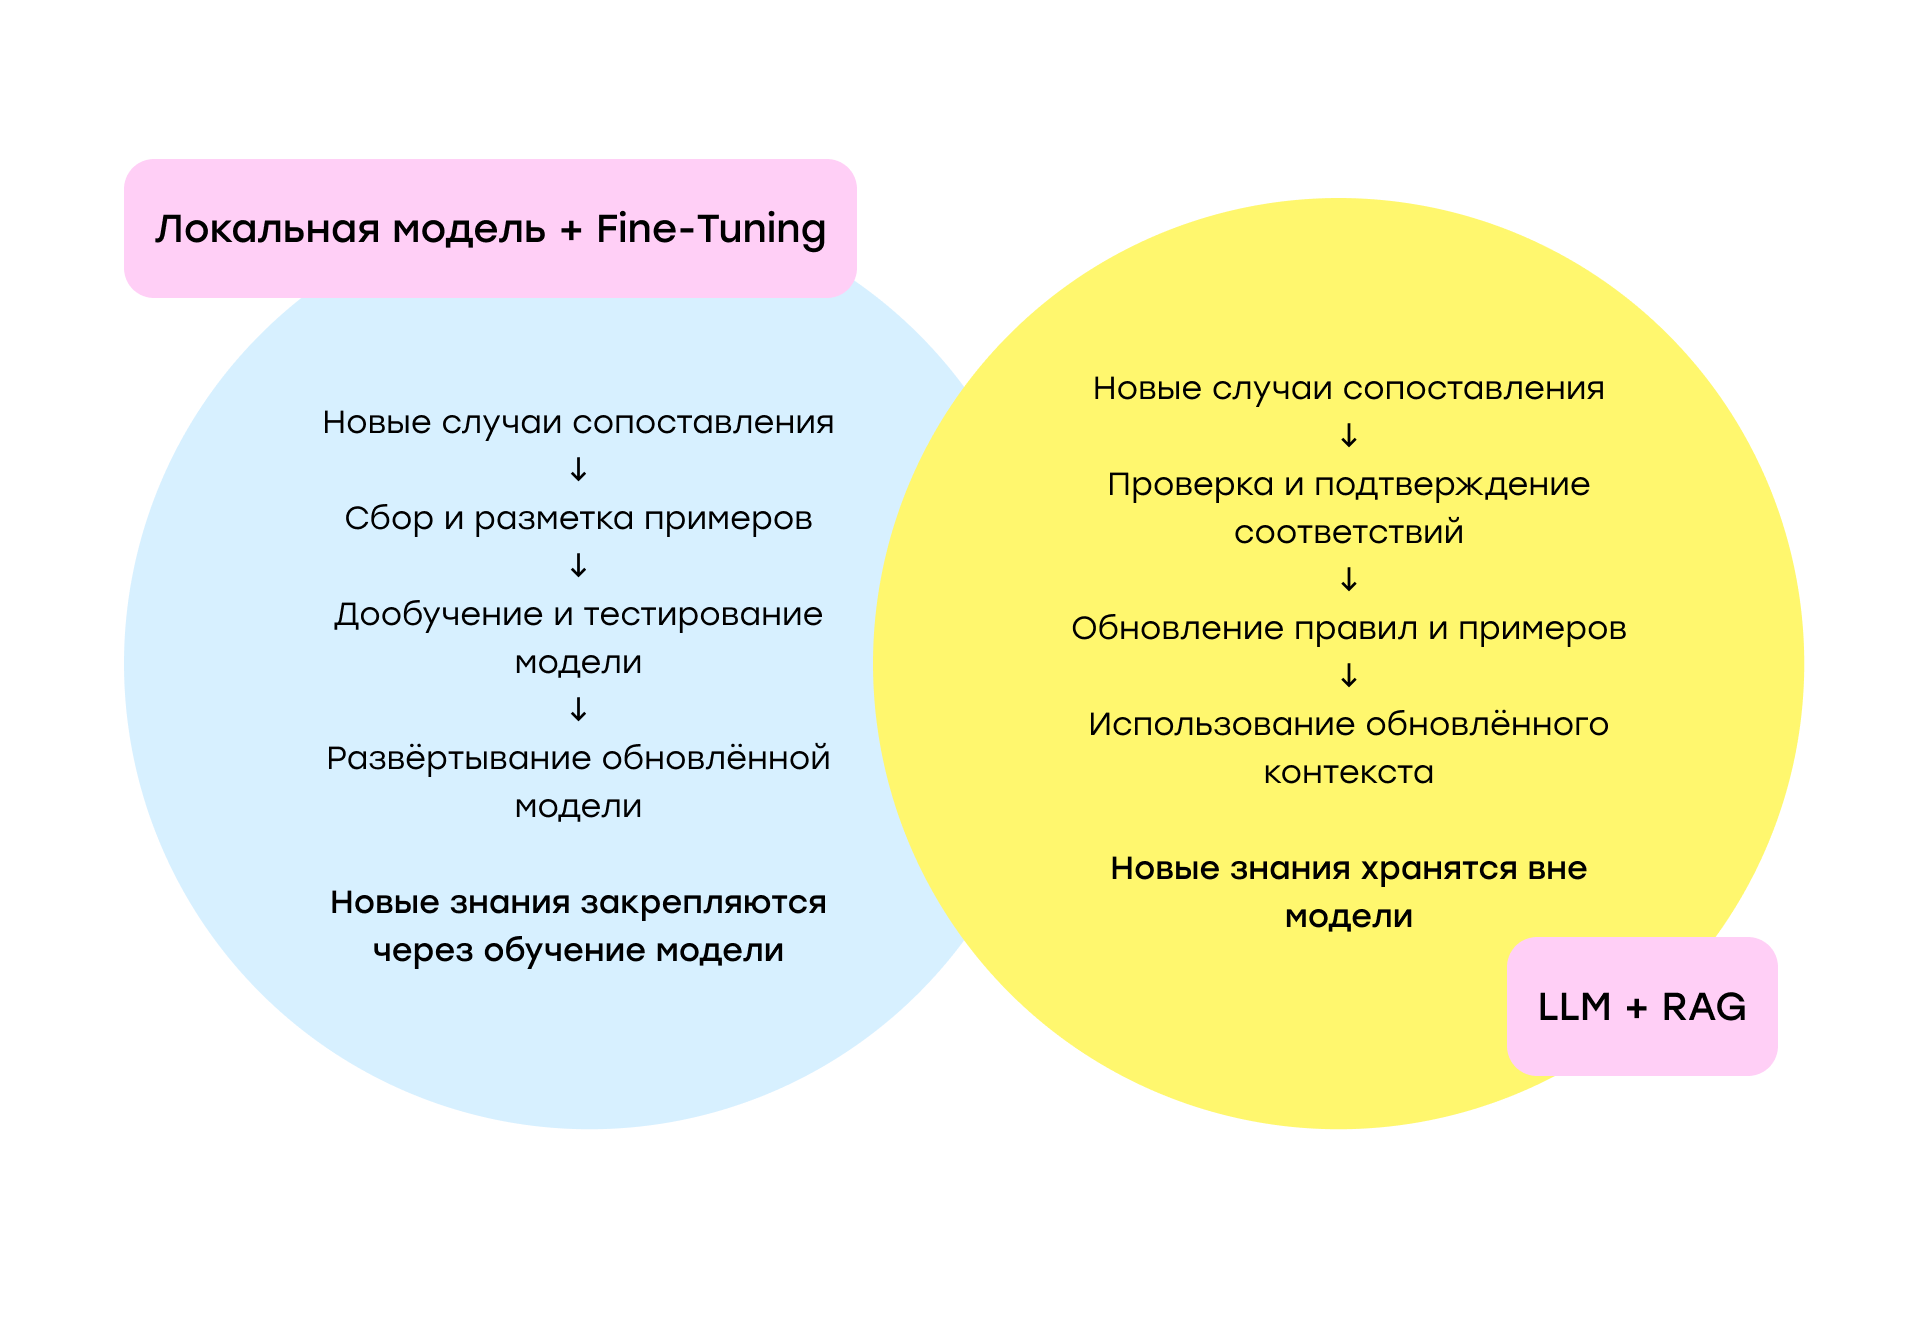
Если специалист подтвердил сложную товарную пару, этот случай можно сохранить в базе проверенных решений.
Когда позднее появится похожая ситуация, система сможет найти релевантный исторический пример и передать его LLM как дополнительный контекст.
Получается два способа хранения изменяющихся знаний:
- Явные бизнес-правила и справочники, применяемые программно.
- Проверенные исторические примеры, используемые через retrieval.
Это не означает, что fine-tuning больше никогда не понадобится. Но появление новых данных не обязательно должно приводить к изменению весов модели.
Иногда достаточно обновить словарь, конфигурацию или набор проверенных примеров.
При этом RAG тоже требует контроля качества: устаревший или нерелевантный пример может привести к неправильному решению.
А не станет ли такая система слишком дорогой?
Разделение задачи на несколько этапов повышает управляемость, но добавляет техническую сложность.
Кроме того, вызовы облачной LLM создают регулярные расходы.
Можно было бы заранее извлекать подробные фасетные свойства каждого товара во всём каталоге. Это потенциально улучшило бы поиск аналогов с сильно различающимися названиями.
Имея структурированные характеристики, система могла бы искать товары не только по текстовому сходству, но и по сочетанию конкретных параметров.
Однако при обработке сотен тысяч или миллионов позиций возникает вопрос стоимости.
Извлечение характеристик с помощью LLM для всего каталога может потребовать значительного количества запросов и времени обработки.
Альтернативный подход — сначала использовать относительно дешёвый поиск кандидатов и только затем применять LLM для более глубокого анализа.
Это уменьшает расходы, но создаёт риск пропустить правильное соответствие ещё на первом этапе.
Поэтому приходится искать баланс между полнотой поиска, скоростью и стоимостью.
Для некоторых бизнес-задач пропущенное соответствие может быть дорогостоящей ошибкой. Для других допустимо передавать небольшую часть сложных случаев на ручную проверку.
При больших объёмах данных также становятся важны пакетная обработка, повторное использование уже извлечённых характеристик и сокращение количества повторных обращений к LLM.
Та же логика относится к выбору между облачной и локальной моделью.
Локальный вариант может быть дешевле при больших стабильных объёмах, но требует инфраструктуры, обслуживания и, при использовании fine-tuning, регулярной работы с обучающими данными.
Облачные модели позволяют отказаться от части собственных инфраструктурных затрат, но создают зависимость расходов от количества запросов и объёма контекста.
Поэтому сравнивать нужно не только стоимость одного API-вызова, а полную стоимость получения результата нужного качества.
Заключение: проблема не всегда в модели
Когда LLM неправильно сопоставляет два товара, естественная реакция — улучшить промпт, выбрать более мощную модель или подготовить новый набор данных для fine-tuning.
Иногда это действительно помогает.
Но прежде чем менять модель, стоит понять причину ошибки.
Возможно, правильный кандидат вообще не попал в результаты поиска. Или в исходных данных не хватало важного атрибута. Или два эквивалентных значения были ошибочно признаны конфликтующими.
А иногда системе просто неизвестно бизнес-правило, по которому товары должны считаться соответствующими.
Все эти проблемы требуют разных решений.
Для автоматического сопоставления больших товарных каталогов важны не только способности языковой модели, но и качество исходных данных, поиск кандидатов, извлечение и сравнение фасетных характеристик, а также правила принятия решений.
Вместо того чтобы пытаться научить одну модель всему, зачастую полезнее построить систему, в которой каждый компонент решает свою задачу, а изменяющиеся знания можно обновлять без перестройки всей архитектуры.
Автоматизируем сопоставление каталогов с помощью ИИ
Технологика умеет работать с фасетными свойствами товаров, большими объемами данными, интерпретацией данных с LLM и ранжированием моделями машинного обучения.
Напишите нам и вам больше не придётся сравнивать каталоги вручную.